俺たちの日常は推理小説ではない:個人向けLLM-wikiの使い道を考える

気づいたら、ブログを書く習慣が無くなっていた。
最近ちょっと気になっていた「LLM-wiki」について、今日は考えてみたい。

LLM-wikiとは何か

LLM-wikiとは何かについて、今更俺がわざわざ書く必要はないだろう。
とりあえず原典へのリンクを貼っておくので、手元のLLMに入れて要約するなり読むなりしてみてほしい。

LLM-wiki

著者のKarpathy氏は、「これは詳細な説明ではなく抽象的な枠組みであり、実際の運用は各自のLLMと相談してほしい。あなたに合った具体的な実装をLLMが考えてくれる」と書いている。
個人の置かれた状況や管理している対象は人それぞれ全く違うのだから、「全員にそのまま当てはまる単一の手法がある」という前提で書く方が無理がある。
そうではなく、「骨組みだけ提示するから、あとは個々人に合わせて適宜調整してほしい」という考え方の方が合理的だと思う。

ただ、これだけだと「結局何を蓄積すれば役に立つのか」「どういう情報を入れていけばいいのか」がいまいち判然としない。
そもそも、LLM-wikiで扱う「知識」とは何なのだろうか。

パーソナルナレッジマネジメントでマネジメントする「知識」とは何か

提唱者のKarpathy氏が書いた第一文がこれだ。

A pattern for building personal knowledge bases using LLMs.

というわけで、LLM-wikiは個人の知識ベースやナレッジマネジメントのための手法である。
そこで疑問に思うのが、ここで扱う「知識」とは一体何なのだろうか、という点だ。

仕事の業務であればかなり分かりやすい。
たとえば俺のようなITエンジニアの場合、開発しているシステムの仕様は日々変わる。
ある機能について一度はAという方法で進める合意ができても、問題が見つかってBに変更されるような事態は日常茶飯事だ。
しかし古い会議資料や議事録には「Aに決定」と書かれたまま残るため、過去の文書だけを参照していると最新の状況を間違って理解する可能性がある。
したがって、時とともに移り変わっていく最新の仕様をLLMを使って整理し直すことには大きな意味がある。
Karpathy氏が応用例の一つに挙げている「Business/team」がこれに当たる。

一方で、個人の場合はかなり難しいのではないか。
応用例の一つに書いてある「Research(研究)」は納得がいく。
論文をたくさん読む研究者であれば、複数の論文の主張の違いや関連性、あるいは自分が進めている実験の途中成果などを蓄積し、相互のつながりを把握しておく価値は十分にあるだろう。
しかし、そうした研究や専門的な調査以外の日常生活において、この知識ベースが役立つ機会があるのかはだいぶ疑問である。

Ask a subtle question that requires synthesizing five documents, and the LLM has to find and piece together the relevant fragments every time. Nothing is built up. NotebookLM, ChatGPT file uploads, and most RAG systems work this way.
例えば、5つのドキュメントの内容を統合しなければ答えられないような、少し複雑な質問をするとします。その場合、LLMは毎回、関連する断片を探し出し、それらを組み合わせなければなりません。何も積み上がっていきません。(ChatGPTの訳)

Karpathy氏は、LLM-wikiがRAGと比べて優れている点を説明する際に、上記のように述べている。
しかし、5つのドキュメントの内容を統合する必要があるような複雑な質問は、日常生活でそれほど頻繁に出てこないだろう。
俺たちの日常生活は、推理小説や謎解きではない。
その疑問をGeminiにぶつけてみたら、「普段扱う情報を3種類に分けて考えてみると良い」と返ってきた。

  • 一問一答で終わる事実:電車の乗り換え案内やLinuxコマンドの書き方など。その場で調べて終わりであり、手元に蓄積する必要がない情報。
  • 消えていく日々の記録:日々の食事や散歩の感想など。日記として残す価値はあるが、Wikiとして相互リンクを張って手入れを続ける対象には向かない情報。
  • 自分で判断するための全体像:ネットで検索しても唯一の正解が載っておらず、複数の情報や自分の体験を突き合わせて「自分なりの方針」を固める必要があるもの。Karpathy氏や実践者たちが「知識」と呼んでWikiに蓄積しているのは、この3番目だけだという。

そして普段の生活で扱う情報のほとんどは1番目と2番目である、とGeminiは言っている。
まあ妥当だろう。
そう考えると、LLM-wikiに興味はあるものの、わざわざ個人のために知識ベースを立ち上げる必要まではないのではないか、という気分になってくる。

個人による実践例

仕事上のプロジェクトではなく、個人のプロジェクトの実例はないのかとAIに検索させてみたところ、Casey Newton氏(ジャーナリスト)の例が出てきた。

  • 記事:An LLM wiki changed how I work
  • 運用内容:日々のニュース記事を保存し、スクリプトとClaudeを使ってWikiに取り込む運用を1か月以上継続している。
  • 成果:数週間にわたって少しずつ新事実が判明する複雑な事件を追う際、時系列や事実関係が自動で整理され、執筆前の確認作業が大幅に軽くなった。
  • 課題:放置すると特定の企業ページが1万語を超え、内部リンクが千数百個に達するなど人間が読めない長さに膨れ上がったため、文章を短縮する別の手入れが必要になった。

英語版Wikipediaでもこの人は「テクノロジー・ジャーナリスト」と紹介されているし、大量の情報を読み込んで文章を書くこと自体が本業の人なので、この手法と相性が良いのは納得がいく。

私は、OpenAI / Hugging Faceのエージェントによる情報漏洩事件のような、急速に展開する複雑なケースで、この方法が非常に役立つことを実感しました。この事件では、数週間にわたって数日ごとに少しずつ新たな情報が得られました。毎日、記事を書いたり、ポッドキャストを配信したり、他の人のポッドキャストに出演したりする準備をする際に、このページを開いて記憶を呼び起こし、同時に元の情報源を開いて、これから話す内容が妄想ではないことを確認していました。(Google翻訳)

「推理小説みたいな複雑な情報検索は、普通の日常生活では起きないだろう」と俺は上で否定していたが、この人の場合はそうした複雑な調査を仕事として実際に行っている。
だからこそ、彼にとってはLLM-wikiが実用的な仕組みとして役立ったのだとよく分かる。
ここまで見てみると、Newton氏の使い方は、応用例の中の「Research(研究)」であると言える。学術研究をしているわけではないが、やっていることはまさに研究と言えるだろう。

この事例は個人が運用するwikiであることは間違いないものの、仕事の業務と渾然一体になっている。
業務とは完全に切り離したプライベートな日常用として同じように作るとなると、やはり維持するのは難しいのではないだろうか。
仕事以外で日常的に膨大な情報を取り込み続ける人は、それほど多くないように思う。

ほかにもいくつか試行例は見つかったが、「試しに作ってみた」という段階で止まっているものが多く、長期的な実践例とは言えそうになかった。
Karpathy氏が最初に言い始めてから半年余り経つが、個人でLLM-wikiを運用し続けて役に立っているという実例があれば、ぜひ教えてほしい。

それでは。

(Aqua Voiceで音声入力 → Gemini 3.8 Flashで修正 → 最終確認して手直し)
業務のやり方が変わったのは、Claude Codeを導入したときではなく外部ツールと連携したときだった

業務のやり方が変わったのは、8月にClaude Codeを導入したときではなく、10月に外部ツールと連携したとき

今年の8月から、会社の業務でClaude Codeを使い始めた。それより前はGitHub Copilotを使っていて、導入当初はそれほど大きな変化を感じていなかった。
もちろん、いくつか変化はあった。具体的には、Claude Codeを導入することで最新のOpusが使えるようになってモデルが賢くなった。また、VS Codeの右側ではなくPowerShell(CLI)から呼び出す運用に変わった。ただ、「それだけの違いかな」という印象であった。
その後、個別にカスタムスキルを作成したり、「こういう表現は避けてほしい」「このやり方はやめてほしい」と伝えた指示を、記録せよと明示せずともメモリ機能で記憶してくれるようになったりして、少しずつ自分好みの挙動に近づけることはできた。これもClaude Codeになって変化した点だな。

決定的な違いが起きたのは、10月に入って外部ツールと連携して以降である。といっても、特別なことはしていなくて、日々の業務の中心になっているGitLab、Googleドライブ、Slack、Googleカレンダーの4つをClaude Codeに接続した。Gmailは、業務上の重要度が低いのでまだ接続していない。これらを接続したことで、業務の流れや全体像をClaude Code側から把握できるようになった。
例えば、「今日予定されている会議は何か」「まだレビューしていないGitLabのマージリクエストはあるか」と確認できるようになった。疲れてきたときには「軽めのタスクを1、2個選んでほしい」とClaude Codeに頼めば、すぐに候補を出してくれる。
完璧にうまくいくとは限らず、まだ粗い部分はある。例えば、すでにSlackで返信済みの内容を未対応と誤認して提案してくる(これはClaude Codeが毎回Slackを見に行って状況を確認・更新するわけではないからである)。
それでも、外部ツールと連携していなかった頃と比べるとできることが大きく増えて、まともなタスク管理ができるようになった。単にコードについてチャット上で会話をする・コードを編集するためのツールでは無くなり、ツールの役割が大きく変わったと感じている。

AI生成丸出しの記事が気になりすぎる

「業務が変わったのは8月のClaude Code導入ではなく10月の連携」という見出しを思いついてこの記事を書き始めたが、考えてみたら「XではなくY」という対比の構文はAIが頻繁に使う表現である。
いろいろな所で指摘されているが、AIが多用する表現の筆頭がこの「XではなくY」というパターンである。 実際に文章を読んでいても本当によく見かける。

二項対比(Not X. It's Y.)
「Aではなく、Bだ」「単なるAではなく、Bだ」
その文章、AIに書かせただろ|だいち | GENSHI AI

AI構文で最も有名なものは 「Xではなく、Yです」(It’s not X — it’s Y) だろう。
AI語に親しむ — まだいる

そもそもこの記事を書こうと思った動機は、業務の進め方が変わったのは、ツールを単に導入した時点の8月ではなく、外部ツールとの連携を整えた10月だったという実感を書き殴っておきたかったからである。ところが、自分の頭に浮かんだ言い回し自体がAIの典型パターンときれいに重なっており、自分の思考までAIに影響されたのではないかと不思議な違和感を覚えている。

最近は「AIが書いた文章かもしれない」と感じたら、すぐにCtrl+Fを押して「ではな」と検索する癖がついた。これで「Xではない」「Xではなく」という言い回しを探せる。
例えば最近見かけて、読めば読むほどチンプンカンプンだったこの記事、検索するとこの通りである。まぁ、やっぱりAI出力をそのまま掲載しましたね。道理で読んでも意味がわからないわけだ。

レビュー記録を数え直すと、半分以上が「重大な指摘なし」で終わり、書いていたのは指摘ではなく「見なくていい理由」でした。
半分以上が「重大な指摘はありません」で終わっていました。その 36 件に費やした約 10 万字は、指摘を書くためではなく、指摘が無いという結論を支えるために使われています。要するに、当時のレビューの主な成果物は、指摘ではなく見なくていい理由だったことになります。
https://dev.classmethod.jp/articles/pr-review-judgment-left-after-ai/ (強調は引用者による)

ついでにもう1件だけ、山手線を一周したという記事から。 まず「地面の記憶」とかいう謎の単語がAI臭さを感じるんだけど、「XではなくY」構文もしっかり大量発生している。
文体によっては「じゃな」で検索する必要もあるんだな。

徒歩一周してると、この辺から「駅名」ではなく「次の休憩地点」として見るようになる。

でも一度やると、山手線の見え方は確実に変わる。路線図の丸い線が、単なる線じゃなくなる。
「あそこに坂がある」「あそこは人が多い」「あそこは急に街が変わる」と、全部地面の記憶になる。
https://anond.hatelabo.jp/20261002151015 (強調は引用者による)

現時点でのAIの使用状況(プライベート側)

プライベートにおける現在のAI利用状況についてもメモしておこう。 私は毎月のように契約するサービスを頻繁に見直すタイプではない。ここ1年ほどは同じ構成のままで、Cursor(月20ドル)とAqua Voice(月10ドル)を利用しており、合計で月30ドルほど支払っている。
ただ、Aqua Voiceを使い続けるべきかについては少し迷っている。最近Android版の提供も始まり、サービスの拡充は進んでいるようだが、文章を入力するだけならCursorやChatGPTにも音声認識の機能は備わっているので、直接打ち込んでも事足りる。
また、他の入力手段やAIサービスと比較して、Aqua Voiceの性能が顕著に優れているとまでは言い切れないのが現状である。日本語の精度は弱い気がする。

そう考えていたら、Cursorの料金改定が発表された。これまで月20ドルを支払っていたプランが、Twitter(Xとは呼ばないぞ)の青バッジとの抱き合わせのような料金設定になり、月30ドルに値上げされるそうだ。Cursorの開発元がxAIの傘下に入った影響であろうが、関係のないサービスを一緒に混ぜないでほしい。
SpaceXAI、「Grok」「Cursor」「X Premium」を1つにまとめた「The X Subscription」を発表 - 窓の杜

うーん、どうしようかな。業務でClaude Codeの良さを実感し始めているため、プライベートでもCursorに拘泥する理由はないように思う。ClaudeCodeに乗り換えるかもしれない。
いや、そうすると問題がある。今回のように文章を書く用途では、Claude系の出力はいかにもAIが書いたような不自然な文章になりがちで、それだと難しい。その点、Cursor経由で使えるGeminiは日本語の表現がとても自然で、文章作成においては頭一つ抜けている印象がある。

そういえばAI駆動開発をしていない

AI駆動開発をしているかどうかについては、仕事とプライベートで状況が異なっている。 仕事ではClaude Codeを積極的に使ってAI駆動で開発を進めている。一方で、プライベートで使っているCursorはWebサイトやアプリケーションの開発には使っていない。主な用途は俺自身のタスク管理であり、それも専用のツールを自作しているわけではなく、ObsidianのMarkdownファイルをCursorで編集しているだけである。これがベストかは分からないが、現状はこの運用に落ち着いていて、1年ちょっと続いている。

なぜ自分はプライベートで開発をしないのか、自分でも不思議に思っている。
今はエンジニアに限らず、誰でもAIと対話しながら作りたいものを形にできる時代である。それにもかかわらず、自分はテキストファイルの編集をしているだけで、アプリやWebサービスを作っていない。この点には以前から自分で疑問を感じていた。
結局のところ、そこまでして作りたいサービスがないというのが原因なのだろう。たとえばDDR(Dance Dance Revolution)にめちゃくちゃ熱中していれば、スコアを記録・管理するツールを作っただろう。広く公開するサービスでなくても、自分専用のツールとして作ることもできたはずだ。なにせ、AI駆動開発は自分が一番使いやすいものを作るのにはうってつけなのだから。
……そういえば、以前にフレアスキル計算用のツールを作ろうとしたこともあったが、途中で面倒になってやめてしまった。開発を継続するほどの動機が続かないまま、現在に至っている。

まとまりがないけど今日はそんな感じです。

AIで音声メモを文章整形するための最適なプロンプトを探して、5段階の強度を比較した

概要

最近、音声入力でメモを取ることを試している。タイピングに頼らずに、パソコンに向かって話すだけでテキスト化されるのは快適だが、出力は言い直しや繰り返しが多く、そのままにしておくのは少しもったいない。これを綺麗にしようとcursorのAIを叩いてみたが、どうも望む通りの結果が出てこない。
そこでこの記事では、同一の文章に対して複数の文章整形プロンプトを実行して、どのような結果が出るかを実験した。自分のための技術メモの側面が強いが、もし誰かの役に立つことがあれば幸いである。

はじめに 文字起こしをAIで上手く整形したい

文字起こしのサービスAqua Voiceを使い始めた。精度が高かったので、すぐに有料モードに加入した。そのため、プライベートのメモは1人でブツブツ喋って音声でメモを取ることが増えた。ただしこの方法だと、当然フィラーや言い直しが多い。そこでCursorの出番である。CursorのAIに要約をしてもらっている。いや、要約というのは少し不適当かもしれない……冗長な語を取り除くことをお願いする。しかし、出力文章が予想以上に削除されて短くなったり、逆に削除が不十分で長くなったりと、うまくいかないことがあった。そのため、どういう要約用プロンプトを実行するとどういう結果が返ってくるのかというのを一旦まとめてみたい。
(注意:フィラーとは、「えーと」や「あのー」といった、言い淀んだときに出る言葉のことである。)

実験の設定

サンプル用の入力文

入力となる文章がないと始まらないので、サンプルの例文を用意した、というか自分でパソコンに向かって適当にしゃべった。
(1回目に今日の晩飯について語ったら、Aqua Voiceが不調で途中部分の文字起こしに失敗していた……ショックだ。)

え〜どうしよう、6月だというのになかなかついですね。なんか梅雨入りした本当は梅雨入りしたことは知っているんだけど、梅雨はどこに行ってしまったのかといった感じのお天気である。今日も晴れて最高気温は33度ぐらいになったと思う。夕ご飯を食べた後に軽くジョギングに行きました。今日もリモートワークだったので、家からほとんど出ないと全く運動不足になってしまうから。まあ、というわけで、夜に本当に軽いジョギングに行ったんだけど、夜に走っても結構汗ばむくらいの気温であった。確か研究法によれば少しは雨になるらしいが、ちょっと確認してみよう。研究法を確認してみたら、明日は曇りのち雨だ。久しぶりに雨が降るみたいだ。

Aqua Voiceは喋った結果の音声ファイルを内部で保存しているので、聞き返してみた。Aqua Voiceは結構フィラーを削除してくれる。実際の音声ではもっと「えーと」「まぁ」といったフィラーが多い。

なお、上記には少し文字起こし誤りがある。

  • 「なかなかつい」→「なかなか暑い」
  • 「研究法」→「天気予報」

今回はこのままcursorに入力してみよう。

モデル

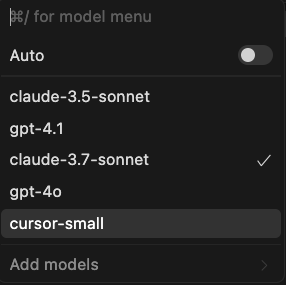
これは俺の用途の関係上、cursorのエディタ内部で使えるモデルから選ばなければならない。
現状(2025年6月23日現在、cursor 1.1.3)エディタ内部のAIで使えるモデルは以下の通りになっている。

  • claude-3.5-sonnet
  • gpt-4.1
  • claude-3.7-sonnet
  • gpt-4o
  • cursor-small

Text Arena | LMArena とかを調べたけど、claude-3.7-sonnetよりもgpt-4.1のほうが全体的な性能が良いんですかね? gpt-4.1 を使うことにする。

要約するためのプロンプトを考える(作ってもらう)

文字起こしの方法は、「素起こし」「ケバ取り」「整文」という3種類がある。

「素起こし」とは、録音した内容を聞き、聞こえた音をそのまま一字一句正確に書き起こす方法です。
「ケバ」とは文脈上意味を持たない「あのー」「えー」「ああ」「~ね」「~よ」などの言葉を指す用語であり、「フィラー」と呼ばれる場合もあります。
(中略)ケバをきれいに取り除くだけで文章がスッキリし、非常に読みやすくなるのです
「整文」とは、話し言葉を書き言葉に直し、文体をですます調に整える方法です。助詞の補充や、ら抜き言葉の訂正などを行うので、非常に美しく読みやすい文章に仕上がります。
「素起こし」「ケバ取り」「整文」の違いを理解しよう! | コラム | VoXT One(AmiVoice)

ただ「整文」は「要約」ではないんだよな。「整文」は原文にあった意味が欠落する加工ではないはず。

Gemini 2.5 Pro 他に「入力された文章を整えるためのプロンプトを考えて出力して」と言って、プロンプトを作成してもらった。
下記の結果とセットで記載している。

結果 プロンプトと出力結果

5個のプロンプトと実行した出力結果を示す。(他にも試してみたが、上手くいかなかったものは省略。)
一応、元の文章の前後の部分が結果に影響する可能性があるため、新規ファイルを開いてそこに上記のテキストを貼る形で検証した。

レベル1

プロンプト:
フィラーや言い淀みを除去し、誤字脱字を修正して、自然な話し言葉として整えてください。
結果:

どうしよう、6月だというのになかなか暑いですね。梅雨入りしたことは知っているけれど、梅雨はどこに行ってしまったのかという天気です。今日も晴れて、最高気温は33度くらいだったと思います。夕ご飯を食べた後に軽くジョギングに行きました。今日もリモートワークだったので、家からほとんど出ず、全く運動不足になってしまうからです。夜に軽くジョギングに行ったのですが、夜でも結構汗ばむくらいの気温でした。確か天気予報によれば少しは雨になるらしいので、確認してみたら、明日は曇りのち雨だそうです。久しぶりに雨が降るみたいです。

レベル2

プロンプト:
口語は残しつつ、全体のフィラーや言い直しを除去し、多少文脈を調整して自然な話し言葉に整えてください。
結果:

どうしよう、6月なのになかなか暑いですね。梅雨入りしたことは知っているけど、梅雨はどこに行ってしまったんだろうという天気です。今日も晴れて、最高気温は33度くらいだったと思います。夕ご飯のあとに軽くジョギングに行きました。今日もリモートワークだったので、家からほとんど出ず、運動不足になりそうだったからです。夜に走っても結構汗ばむくらいの気温でした。天気予報によると、明日は曇りのち雨らしいです。久しぶりに雨が降るみたいですね。

レベル3

プロンプト:
冗長な表現や遠回しな言い方を、より簡潔で分かりやすい表現に修正してください。
結果:

6月なのに暑い日が続いています。梅雨入りはしているはずですが、雨が降らず晴れて最高気温は33度ほどでした。夕食後に軽くジョギングをしましたが、夜でも汗ばむほどの気温です。リモートワークで運動不足になりがちなので、夜に走るようにしています。天気予報を確認したところ、明日は曇りのち雨で、久しぶりに雨が降るようです。

レベル4

プロンプト:
口語的な表現を書き言葉に直し、文章の構成を整えてください。要点が明確に伝わるようにしてください。
結果:

6月にもかかわらず、連日暑い日が続いています。梅雨入りしたことは知っていますが、梅雨らしい天気にはならず、今日も晴れて最高気温は33度ほどでした。夕食後には軽くジョギングをしました。リモートワークのため外出する機会が少なく、運動不足になりがちだからです。夜に走っても汗ばむほどの気温でした。天気予報によると、明日は曇りのち雨で、久しぶりに雨が降るようです。

レベル5

プロンプト:
文章の要点のみを抽出し、簡潔な文章で再構成してください。元の表現にこだわる必要はありません。
結果:

6月なのに暑い日が続き、今日も最高気温は33度だった。リモートワークで運動不足を感じたため、夕食後にジョギングをした。天気予報によると、明日は久しぶりに雨が降る見込み。

考察

どのようなプロンプトを作れば結果がどこまで短くなるか、予想通りにはいかず、調整が難しい。
レベル3とレベル4の結果がそんなに変わらない長さだった。レベル5で一気に短くなったので、4と5の間の縮約になるプロンプトが作れないか少し試したけど、上手くできなかった。

また、文体についても改善の余地はある。今回は、「ですます調にしろ」とか「箇条書きにしろ」のような特段のスタイルの指示をしないようなプロンプトにした。希望する文体があれば当然それをプロンプトに入れる方が良い。
例えば下記の記事には、2人がしゃべっているPodcastの文字起こしに対して、特定の形式で出力をしてもらうためのプロンプトがある。
ポッドキャストをAIで文字起こしして図解する手順|ノウチ
上記では、出力形式や実行すべき処理をかなり具体的に指示している。
今回の実験はプロンプトがシンプルであることを優先したので、割と短めのプロンプトにした。

先程の「素起こし」「ケバ取り」「整文」との対応関係を見ると、もう文字起こしをした段階でフィラーはある程度削除されているので素起こしにはならない。
「ケバ取り」はフィラーを除去して最低限きれいにするくらいなので、レベル1の結果だろう。
「整文」がどれに当たるかは、どこまで文を整理したいかによる。レベル5まで行くともはや別物なので、レベル2〜4のどれかだろう。

応用としては、例えば各レベルのプロンプトを辞書登録しておいて、すぐに呼び出せるようにしておくことが考えられる。「ケバ取り」をしたいときはcursor上でレベル1のプロンプトを呼び出して実行すれば良い。

今回の実験の限界について。モデルは今回gpt4.1だけにしたが、このモデルが違うと当然結果が違う可能性はある。さらに元の文章も1つしか無い。あとはAqua Voice以外の文字起こしだとそもそも入力文が変わってくるな。(仕事のときはWindows標準の音声入力をつかっているが、アイツはフィラーを入れてくるし、やたらと句読点を入れてくる)ちゃんと定量的に議論しよするには、複数のモデルで複数回実験して……とやる必要があるが、学術論文でもないので簡単な実験でとどめておく。

余談:この作業にObsidianは本当に必要か?

考えてみると、今回の作業をするうえで使っているツールは3つある。Aqua VoiceとObsidianとCursorの3つだ。この3つのツールの担当範囲を箇条書きにすると、こうなる。

  • Aqua Voice:入力された音声を文字に起こす
  • Cursor:AIを呼び出し、プロンプトを実行して文字起こしを整形する
  • Obsidian:デイリーノートの作成と保存

しかし、この3つの貢献度合いは明らかに違う。私が喋った内容が精度高く文字起こしされるのはAqua Voiceのおかげである。私の言い回しが適宜省略され、簡潔に冗長な箇所が削除されて簡潔になるのはCursorとその向こうのAIのおかげである。

ここでObsidianは何をしたかというと、特に何も貢献していない。テキストファイルを扱えるエディタでありすれば良いので、別にObsidianではなく、他のエディターでも良い。例えば使い慣れたVS Codeでも別に問題はない。
強いて言えば、Command+Shift+D のショートカットキーでデイリーノートが開くように設定したので、Obsidianの恩恵は「ショートカットキー一発でデイリーノートを作成して開ける」ことかもしれない。だがそれだけでは、あまりにも小さすぎるのではないか。Cursorの良さはわかるし、Aqua Voiceの良さはわかるけど、Obsidianの良さは未だによくわからない(VS Codeでも良いじゃん)というのが、現時点での私の考えである。

CNBC「AIのVibe Coding時代」を見たメモ

CNBCのYouTube動画を観たので、ちょいと感想を書く。
動画はこちら。

www.youtube.com

CNBCをチャンネル登録しているのは英語学習のためだったが、そこから「Vibe Coding」というフレーズの動画が出てきたのでびっくりした。
AI駆動開発、またはVibe Codingってやつがプログラマーの間ではいま激アツである。QiitaやZennみたいなプログラマー向けサイトにこの話がいくら出てきても俺ももう驚かないんだけど、一般向けチャンネルであるCNBCで取り上げられていて驚いた、っていうのが今回書こうと思った理由。
ただ、全部通して観たわけじゃなくて、動画が40分ある中で前半15分のニュース部分だけ視聴した。後半20分くらいはAbridgeってサービスのCEOとの対談だったからスキップした。
タイトルを見たときはAI駆動開発やコーディングの話に限定した話だ思っていたら、観た感じだともう少し広い内容でちょっと予想外だった。タイトルが一点集中しすぎだろ、と思った。

内容は大きく二つの対立構造で語られていた。
ひとつは汎用モデルを作る側。ChatGPTのOpenAIとか、Claudeを作るAnthropicとか。もう1つは、AIラッパーとかAIアプリと呼ばれる側。コードならCursorやWindsurf、法律ならHarvey、医療ならAbridgeが伸びているらしい。
Googleみたいなビッグテックは既存の収益構造があるから急な方向転換が難しく、既存ビジネスを壊すリスクがある。一方、小規模スタートアップや特化サービスは自前でモデルをファインチューニングして素早くサービスを立ち上げ、急成長できる。という二項対立の構造のようだ。
最初は優れた万能のAIモデルを作ることに注目が集まって、投資の資金も流入した。けれど、最近はAIラッパー、AIアプリに金が流れている。
とはいえ、どちらが善でどちらが悪って話でもなく、ビッグテックも資金力と既存基盤で反撃してくるかもしれないし、これからどう転ぶかはわからない、って感じだった。

具体的なサービス名が結構バンバン出てきてたのでメモしておく。

最近ブログを全然書いていないので、軽い記事としてまとめてみた。この原稿を LLM で整形して、最後に目を通してアップする予定。おしまい。 (ChatGPT o1に推敲を頼んで、各サービスへのリンクを貼っといてと言ったらやってくれた。一応確認したけどちゃんと合ってるな。)

英検1級(2024年度第3回)2次試験面接の質疑メモ、振り返り

2025年3月2日(日)に英検2次試験を受けたので振り返りメモ。(2024年度第3回)
ギリギリ合格だった。

試験開始まで

案内ハガキには「10時15分に集合(時間厳守)」と言われて、ほぼギリギリに着いた。
あ、そうだ。控室に入ると携帯電話の電源は切らなければいけない。(使用すると不正行為に当たる)このことを覚えていなかったが、電車で移動中に面接用の文章のAnkiカードを完了させておいたので良かった。次回も忘れずにそうしろよ、俺。
案内係の女性が「10時40分から試験開始である。ただし。会場には3つ部屋があり、この部屋は3番目である。したがって試験までにはしばらく時間がかかる」という話をしていた。3番目の部屋の中でも私は最後の方に入室したので、私が試験を受けたのは12時の少し前だった。
結構長時間待つことになるが、上述の通り携帯電話は使えないので、勉強するならノートや参考書が必要。

入室〜フリートーク

というわけで会話の内容をメモ。

※ 注意:ここからは一応、私が言おうとした内容/会話の内容を日本語で記述していますが、おそらく英語はこれよりもだいぶ崩れている。また、言い直しも結構多かったと思います。

試験前の前置きフェーズ。 「自己紹介をお願いします」
「ITコンサルタントしてます。AI関連の部署にいるので、毎日AI関連のニュースが出てくるのに追いつくのが大変ですが、楽しいです」
「休日は何をしていますか」
「ゲームしたりYouTubeみたりしています」

自分の仕事内容についてはどこまで答えるかよくわからなくなって、だいぶごちゃっとした(=文構造が崩れた)答えをしてしまった。
そもそも自己紹介をしろと言われていて、自分の仕事について述べよと言われているわけではない。せっかくなら「1回2次試験で落ちたので、次に今回は成功できるようにベストを尽くします」と言うとか、「ゲームを英語の字幕でやっていると英語表現が身に付いて面白いです」とか、言えばよかったかもなぁと今になって思っている。
休日の過ごし方については、無難に「ゲームをしてYouTubeを見てます」と答えてしまった。

スピーチ準備

「では試験を始めましょう」

というわけでトピックを選んで+スピーチ準備の1分間。

https://www.eiken.or.jp/eiken/exam/grade_1/

ここには サンプル問題があるけど、実際はこれよりかなり長い文章だったと思う。 旺文社から出てる過去問を見れば実際に過去に出題されたトピックカードが見られるんですかね?

  • トピック1は発展途上国とか書いてあった気がする。国際関係は行けそうになかったのでパス。
  • トピック2か3で、なんか見て分からない単語があった気がするんだよ。あとセレブがどうとか書いてあった気がして、この辺はマジでわかんないからパス。
  • Twitter検索したら「若者は伝統文化に無関心か」というのが出てきた。うん、2か3のどちらかがこれだったかもしれない。
  • トピック4が私の選んだやつで、就業可能な最小年齢を引き下げることは労働者に良い経験をもたらすか
  • トピック5は確か技術的な発展が将来にわたって永久に続くかみたいなこと

4と5でだいぶ迷う。5番は「YES」と答えれば良さそうだと思ったけど、理由が2つ思いつかなかったので4番にした。
労働関係のトピックはよく出るので、週4日労働制度・男女の格差・リモートワークなどあたりかなと思ったけど、まさか就業年齢の引き下げについての問題が来ると思わなかったので驚いた。
注意点として、valuable experienceという書き方をしていたので、これは会社の立場や政府の立場で答えてはいけない。聞かれたことに対して正しく答えなければいけない。

スピーチ

「一部の人は、就業可能な最小年齢を引き下げることは労働者に良い経験をもたらすと考えていますが、私はそうは思いません。その理由は2つあります。
第一に、(価値ある業務には前提の知識が必要的なことを言えたかなぁ……自信がない。) 私の個人的な経験から言えば、私のいまの業務は大学で学んだことに基づいています。若い年齢で働いても、単純な繰り返しの業務をすることになり、これは価値のあるものとは言えません。
第二の理由として若い人が搾取されると言う可能性があります。自分の会社は悪意を持っていたり、人を騙そうとしていたりするかもしれません。若い労働者は判断力がそれほどないので、そのような会社に搾取される危険性があります。
結論として、就業可能の最小年齢を引き下げることは良い考えではありません。」

第二の理由を言い終わったあたりでタイマーが鳴ったので、「あれ、スピーチを終わったほうが良いの?」と思った。だが制止されなかったので、最後に簡単に結論部分を喋って一応スピーチを終わらせた。

質疑

日本人の試験官「Q. 今、日本では伝統的(traditional)の産業に従事する人が少なく、政府も産業の保存のために取り組んでいます。 農業や漁業といった業界の労働者が不足しています。 例えば、若い人が今すぐ農業や漁業に従事して働きたいと言った場合、働いてもらうのは良い考えですか。」

下のカッコ内は俺がその場で思ったことです。
(この面接官すごいしゃべるなぁ……traditionalというと俺の好きな江戸切子や日本酒の話をすればいいか。いや待てよ。農業や漁業の話なのかー。肯定してもいいけど、そうするとスピーチの自分の内容と矛盾するから、否定で回答するのがいいか。)

「難しい質問だが、私はそうは思わない。農業は機械化されていますし、現代の農業は関連する理論に基づいています。 まず学校で農業の技術などを習得して、それから実際に農業に従事して働けばいいと思います。」
機械化されているから単純労働の必要性は薄い、みたいなことを言いたかったんだと思うけど、多分そこまでちゃんと筋道通った話をできていなかったと思う。

ネイティブの試験官「Q. 貧しい家庭で大学に行けない学生の場合はどうしますか。大学の授業料は、無料では無いですよね。」

「そうですね。高校卒業してから大学に行かずに働き始めるというのは特に問題ないと思っています。その場合は彼らは18歳になっているわけですし、基本的な判断力はあるでしょう。しかしまだ若く判断力が不足することもあると思うので、彼らが搾取されないように、若い労働者を守る法律の整備が必要だと思います。」
あんまり同じ話で終わらせるのは良くないなと思ったので法律の話を最後にくっつけた。enforce lawsという言い回しはAnkiで覚えておいてよかった……。

ネイティブの試験官「Q. 若者が搾取されるというのはあなたのスピーチでも述べていましたね。法律以外にできる対策はありますか。」

(若者がそういう状況に置かれたときに、自分から訴えることが必要で、だとするとえーと……あ、教育だわ。よしこれでいこう。)

「A. 1つの選択肢は教育だと思います。高校等の授業で労働のシステムについて教えておけば、学生が高校を出て働き始めた後で自分の環境が劣悪であった場合、その状況に自分の状況に気づくことができて苦情を提出できると思います」

The problem should be educated to the student in high schoolsとか言ってしまって「あ、マズい」と思ったけどそのまま押し通した。(educateの目的語は人物なので不可。taughtが正解。)
あと最後「file a issue」とか言っちゃったな。いま英辞郎を検索したら「file a complaint」あたりが正解っぽい。

ここで時間終了となった。

反省(帰宅しながら色々思ったこと)

トピックをどう解釈すべきか?

就業可能の最小年齢の引き下げと言うテーマなので、これを落ち着いて考えてみると、よく分からねぇなと。
日本の法律を考えると、就業可能な最低年齢って15歳じゃないですか。これは引き下げようっていうことなのか……? だとすると「中学生が働くことになり、義務教育の機会が奪われるから問題です」の一択になりそうな気がする。
でもいま高校進学率は90%を超えているから、最小年齢で働き始める人ってほとんどいないし、最小年齢を上げ下げすることによる効果はほとんど無さそうだし……。 自分でも何歳から何歳に引き下げる話をしているかよくわからない……と思いつつしゃべっていた。
そもそも問題文では日本の話に限定されていなかったので、一般論で答えるべきなんだろうか。日本の話として喋りますと前置きして、日本限定で語っても良いのかな……? よく分からん。

スピーチについて

せっかく個人的な経験を語っているので、大学で情報工学を学んだとか、プログラミングの知識とかもうちょっと具体的なことを言っても良かったと思った。
「私の個人的な経験から言えば、私のいまの業務は大学で学んだことに基づいています。」だと具体的にどう基づいているのか分からないからね。

農業は機械化されている……は、直前に見てた参考書から思いついたものだったので、最後に粘って勉強したのも無駄ではなかったと思う。多分。

結果発表!

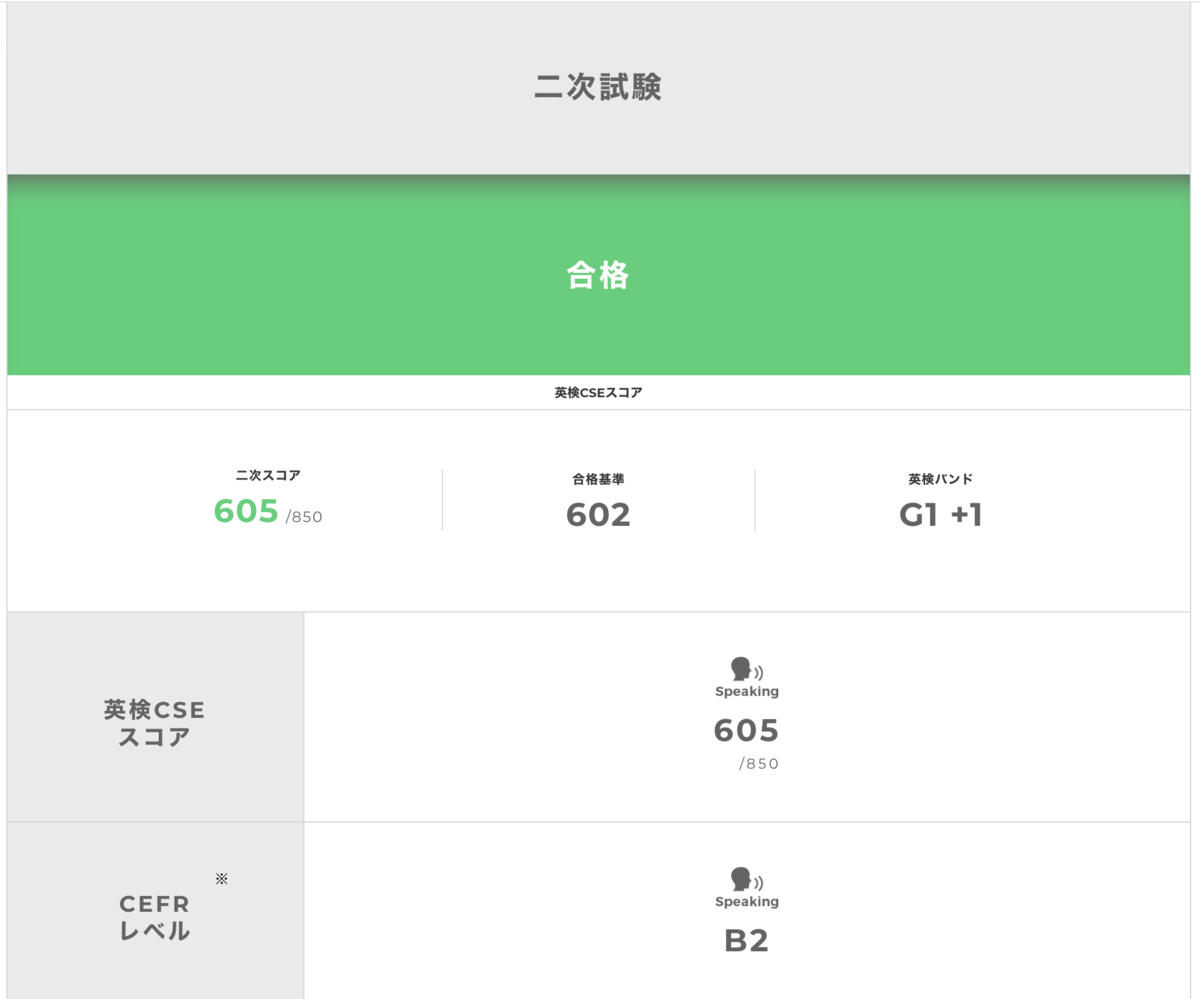
ギリギリで合格してた。

  • SHORT SPEECH 6
  • INTERACTION 7
  • GRAMMAR AND VOCABULARY 7
  • PRONUNCIATION 6

合計26 / 40。これがギリギリで受かるスコアですよ皆さん。 CSEスコアの合格基準が602で、これがCSEスコアが605だった。多分

前回(2024年度第1回)は上から4-6-4-6で不合格だった。我ながら酷いスコアだ。 比較すると、SHORT SPEECHとGRAMMAR AND VOCABULARYが主に伸びたということだな。

感想

英語学習と英検受験を長年続けているとげまるさんが書いている通り、トピックが難しかった。
どれもこれも変にひねったトピックに見えた。素直なトピック、例えば「週4日労働に賛成か反対か」みたいなのはもう出題されないのかな?

最後の質問の教育は「困ったときの教育だな」と思いつつ答えていたが、「困ったときには○○の観点から回答すれば良い」という観点を13個リストアップしている記事を見つけた。
確かに答える観点はある程度似てくるので、いくつかの観点を用意しておけば良いという作戦は納得である。これはいくつか頭に入れておくと便利かもしれない。

note.com

答えられるようにしていた(つもりの)トピックは「インターネット、フェイクニュースと陰謀論、メディア」あたりと「労働問題、働き方」あたりの2点くらいだった。
この辺に山をかけていたわけだ。次はもうちょっと対応可能なトピックを増やしておこう。

試験対策の勉強法などは書きませんが、せっかくなので使った参考書を下に貼っておきます。
それでは。

関連記事

linus-mk.hatenablog.com

生成AIと音声認識によるブログ執筆、お試し_1

2025年3月2日 18:19

いつものように仕事の合間にはてなブックマークを見てたら、面白そうな記事が流れてきたので、ちょっとやってみることにするよ。
まぁ何せ今年に入ってから、気がついたら全然ブログ書いてなかった。なるべく適当に書くようにしないともう全然書かなくなっちゃう。

下記の3つの記事をざっくり読んだ。

honeshabri.hatenablog.com umiyosh.hatenablog.com anond.hatelabo.jp

使用環境は、人によってそれぞれ違うから、記載しておこう。

  • パソコンは割と古いMacBook Pro(2019)
  • スマホは2021年10月購入に買ったOPPO Reno5 A(Android)
  • Obsidianは使ってない、Evernoteは不便になりすぎてやめた、ちょっとだけNotion使っている

「忙しい人向けの説明」のセクションがマジでわからない。

「本しゃぶりというブログにChatGPTの使い方について、面白そうな記事があったのでメモ。なんか音声入力を使うといいらしい。これまで話した内容について整理し、マークダウンで出力して」 と喋っておこう。誤字脱字などの修正をせずに投稿すればいい。

「これまで話した内容」と言うのは、一体どこを指しているのか。一連の会話の末尾でやれと言ってるのかよくわからなかった。
とりあえず言われるがままに、Android版のChatGPTに吹き込んでプロンプトを投げたら、 私がこれまで入力してきた結果に基づくメモリに残ってる情報(英語学習やキャリア関連など)が出てきた。それが期待した通りになってるのか、よく分からない。


以下、私が喋る→SuperWhisperで出力されたテキストをコピー →

以下は、私が1人でしゃべった内容を音声認識に入力した結果です。 言い直しやフィラーを修正し、自然でわかりやすい文章に修正してください。

と ChatGPTに指示→結果を少し手直ししたもの。


SuperWhisperをダウンロードしてみた。公式ページに

https://superwhisper.com/ You can try the Pro features for 15 minutes free, after that the free tier features are available to you forever. The no questions asked refund within 30 days of purchase will always be honored.

と書いてあるとおり、最初の15分間だけプロモード(有料版)を使用できるらしい。では、無料版ではどうなるのか? 15分経過後に検証しようとしたが、説明をよく読むと厄介なことに気がついた。

まず、私のMacBookが古いため、インテルチップ搭載のMacではクラウド版が非対応で、ローカル版のみで動作するという制約がある。そして第二に、クラウド版の機能を使えるのはプロモード(有料版)だけだという。つまり、15分が経過して無料版に切り替わると、私はこのソフトウェアを一切使えなくなる。終了。詰んだ。

もちろん、月額8ドルを払ってProモードにすれば解決する話ではあるが、使い始めて今すぐ課金する気にはなれない。しかし、Macのデフォルトの音声認識がまったく満足のいくものではないのも事実だ。私は話し始めに「まぁ」という単語をよく使うのだが、これがほぼすべて「もう」と誤変換されてしまい、かなりイライラする。

検証して気付いたが、開始から15分が経過したらProモードのお試しが終了するのではなく、15分間の音声を入力したあとという意味らしい。

それはさておき、議事録について思い出した。会議中にメモを取るが、最終的な議事録は構造化された文章になる。しかし、人は最初から整理された形で話すわけではなく、「A」という議題について話していたつもりが、途中で脱線して「B」について議論していることもよくある。そして最終的に「Aの結論って何だったっけ?」と話が戻る。そうなると、議事録では発言順ではなく、話の流れを整理して「Aの結論」としてまとめる必要がある。

同じように、最終的に出来上がるブログの文章も、議事録と同様に構造化したい。しかし、話した順番そのままでは構造的な文章にはならない。そこで、この作業をAIに任せて、大規模言語モデル(LLM)に構造化をさせるのが良いのでは、ということだと理解した。

さて、どうしたものか。SuperWhisperを活用できるのは15分間だけのようで、非常に困っている。15分を超えたら検証が続けられないからだ。その後の代替策としては、Googleドキュメントの音声入力を使うのが良いのかもしれない。または、ChatGPTに直接話しかけるのもありか? 音声認識の精度がどれほど高いかが、最終的にLLMに渡るデータの質を左右するのだろう。

うーん、どうしようか。このまま投稿してしまうか……。

[論文メモ]M3DocRAG: Multi-modal Retrieval is What You Need for Multi-page Multi-document Understanding

画像も文字も表も全部まとめて理解するRAGシステムの提案 Bloombergなど | AIDB

で論文紹介を見かけて、RAG関連の業務を実施している俺としては気になったけど、AIDBって有料会員にならないと読めないのね。 というわけで、自分で何とかすることにした。

論文のArXivリンクは下記: arxiv.org

注意: ChatGPTの無料版(GPT-4o)にPDFを入力して質問しつつ理解したものですが、記事の文章自体は(引用の1ヶ所を除き)全文俺自身が書いています。

どんな論文?

  • M3DocRAG というRAGを提唱。複数文書や複数ページの文書に対応していること、テキストだけではなくその他の視覚情報(図や表など)を読み取れることを特徴とする。
  • また、評価のために新たなベンチマーク「M3DocVQA」を提案。40000ページ・3000ファイルのPDF文書(WikipediaをPDF化したもの)のDocument visual question answering (DocVQA)のベンチマーク。

先行研究と比べてどこがすごい?

論文中のFigure 1

  • (a) Single-page DocVQA → 単一ページに関してvisual question answering (VQA)をしているから、複数のページ/文書に対応できない。
  • (b) Text-based RAG → OCRで文字情報だけを読むから、図や表などの情報が欠落する。
  • (c) M3DocRAG (Ours) →上記2つのいいとこ取りをしました。つまり多くのページやファイルを扱えるし、図や表などの情報(visual information)も扱える。

こう並べてみると、いいとこ取りをしようという発想になるのは自然な気がする。

技術や手法の肝はどこ?

提案手法のM3DocRAG は3つのステップからなっている。

  • 1) Document Embedding (ドキュメントの埋め込み計算) ColPaliというvisual embeddingを使って、PDF文書の各ページの埋め込みを軽鎖する
  • 2) Page Retrieval 質問文に近い上位Kページを抽出するんだろう。細かい手法は分かってないけど。
  • 3) Question Answering マルチモーダルのLM (例えば、Qwen2-VL)を使って、最終的な答えを得る。

論文にするほどの価値(新規性)って何なんだろう? と疑問に思っている。 文書ファイルを画像の形のまま埋め込みベクトルに変換できて、クエリとの類似性を計算できるのであれば、それを使ってRAGを作れるのは当然に思える。 すごいのはColPaliであってM3DocRAGでは無いのでは?

「ColPali」で検索して出てきたこの記事も、この論文が出る前の時点だけど、類似度計算してRAGを作っているようだし。
Qwen2-VLとColPaliでマニュアル用ローカルQAボットを作ってみた

2) Page Retrieval (ページ検索)

入力クエリと各文書との類似度を普通に計算しようとすると、文書の数だけ計算する必要があり、計算コストが高い。 IVF(Inverted File Index)という方法を採っているらしい。

  • 文書に対してembedding計算→クラスタリング をする。
  • 入力クエリが来たら、各クラスタの代表点ベクトルとの類似度を計算する。
  • 入力クエリと近いクラスタに対して、クラスタに属する各文書との類似度を計算する。

類似度を計算する対象の文書が大幅に減るので、計算時間が20s→2sくらいまで減る。
精度はちょっと落ちるけどそれほど顕著な性能劣化ではないので、計算時間の大幅減のほうがメリットが大きいでしょう、ということらしい。
Oracle が出してる記事が図が多くて分かりやすかったのでそちらを参照。
Inverted File Flatベクトル索引の理解

3) Question Answering (質問応答)

ColPaliのembeddingとQwen2-VLのembeddingは別物らしい。

The visual encoder takes K-retrieved page images P_Kq as inputs and outputs visual embeddings (different from ColPali encoder’s outputs).
論文 2.3

ChatGPTに聞いたら↓のように返ってきたけど、論文中にここは書いてないと思うし、真偽のほどは分からない。

ColPaliの埋め込み空間とQwen2-VLの埋め込み空間は異なります。

  • ColPaliは検索タスクの類似度計算用に最適化されており、その埋め込みは視覚情報だけを重視しています。
  • 一方、Qwen2-VLは、視覚情報とテキスト情報を統合して自然言語の形で回答を生成することを目的としており、埋め込み空間が異なる設計です。

議論はある?

この論文にはDiscussion の章が無いので、該当するのはラストのConclusionの後のLimitations 部分ですかね。

  • 元の検索モデル・言語モデルが英語中心のデータセットで訓練されたので、英語以外で書かれたドキュメントやプロンプトで性能劣化する懸念。
  • 誤った/偏った結果が出力される可能性がある→実運用では人間の監視が必要。

Figure 6 をよく調べる

Question: "What distance was the AP Warrior fast race at the Del Mar Racetrack?"
ColPali + Qwen2-VL 7B: "Seven Furlongs"
質問: AP Warrior(競馬の競走馬の名前)がDel Mar Racetrackで走った際のfast raceの距離は何か?
ColPali + Qwen2-VL 7B の回答: "Seven Furlongs"

表の中で Track = Del Mar Racetrack である記録は2つあるから、どっちか分からなくない? と思ってしまった。
もう一つCondition = fast という条件があって、それを満たすのはオレンジで囲った下から2番目の行しか無いね。
Condition って何だよと思ったけど、馬場状態 - Wikipedia / Going (horse racing) - Wikipedia の話らしい……競馬1ミリもわからん。

おまけ:

論文を読む際の落合陽一フォーマットを使った。プロンプトは下記から拝借した。
論文読みフォーマット by 落合陽一 for ChatGPT - work4ai

論文名で調べると、最初に挙げたAIDB以外、LLMが要約したと思われる記事ばっか出てきてちょっと困る。あんまり理解の助けにならないページが検索上位に来るのはどうなんだ。
まぁ、だからこそ、AIDBみたいなサイトが価値を持つのかもしれんが……
それでは。